Context engineering in de praktijk
Meer dan promptformulering
Section titled “Meer dan promptformulering”Tijdens inferentie ziet een LLM niet rechtstreeks een database, repository, geheugenopslag, gebruikersprofiel, beleidssysteem of tools. Het ontvangt een eindige tokenreeks die uit deze systemen is samengesteld.
Prompt engineering vraagt hoe een instructie moet worden geformuleerd. Context engineering stelt een bredere reeks vragen: Wat moet het model nu weten? Welke bron levert dit? Hoe gezaghebbend en actueel is die bron? Hoe moet de informatie worden weergegeven en geordend? Hoelang moet ze beschikbaar blijven?
| Prompt engineering | Context engineering |
|---|---|
| Voornamelijk formulering van instructies | De volledige informatieomgeving |
| Vaak één interactie | Een continu runtimeproces |
| Meestal handmatig samengesteld | Vaak dynamisch geassembleerd |
| Richt zich op hoe je iets vraagt | Richt zich op wat het model moet weten |
| Vooral tekstformulering | Omvat retrieval, geheugen, tools, state, compressie en beleid |
Prompt engineering is dus één onderdeel van context engineering.
Context als working state
Section titled “Context als working state”Voor een agent kan context beter worden begrepen als tijdelijke working state dan als een groot tekstvak. Tijdens een upgrade van een authenticatiebibliotheek kan de nuttige state bestaan uit het doel, de huidige planstap, relevante bestanden, twee falende tests, een besluit om de publieke API niet te wijzigen, beschikbare tools en het verbod op destructieve Git-handelingen.
Deze state combineert vijf aandachtspunten:
- het huidige doel;
- voortgang en omgevingstoestand;
- recente observaties en beslissingen;
- relevante geschiedenis en kennis;
- beperkingen, bevoegdheid en beschikbare acties.
Context is een pijplijn
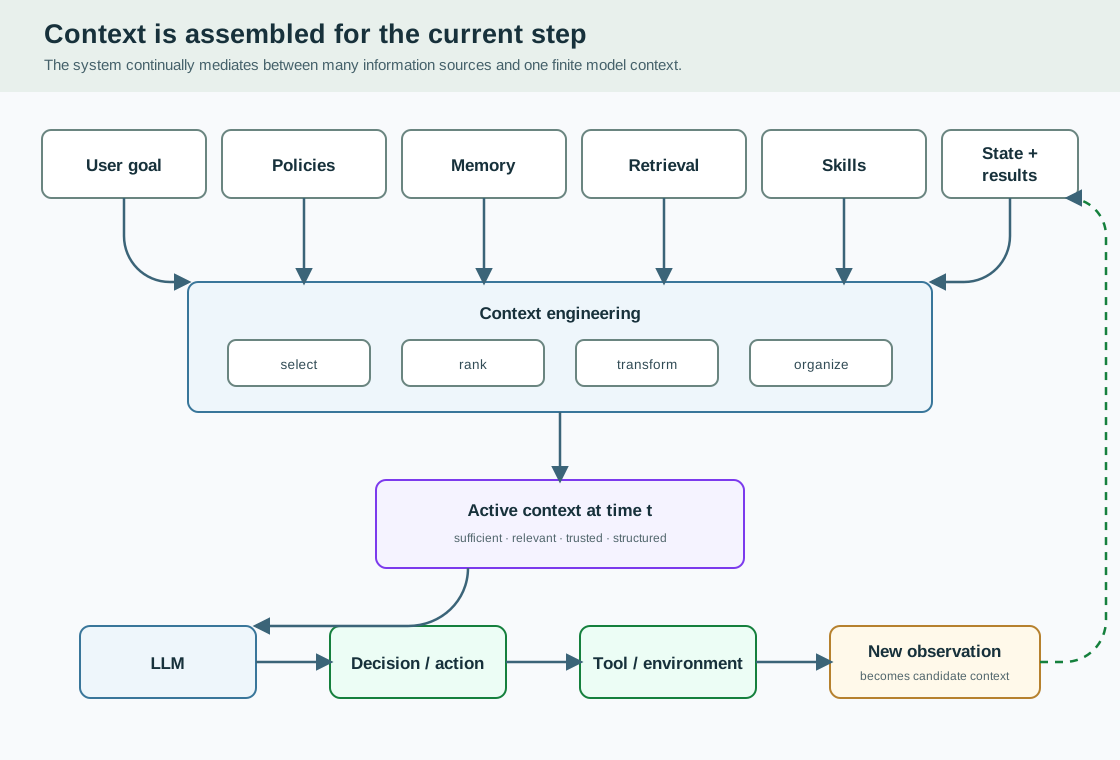
Section titled “Context is een pijplijn”Een robuust systeem dumpt niet alles wat het weet in het contextvenster. Het verzamelt kandidaat-informatie en selecteert, rangschikt, transformeert en ordent deze voor de huidige stap. Het resultaat is actieve context: voldoende, relevante, betrouwbare en gestructureerde informatie voor de volgende voorspelling of actie.
Veelvoorkomende kandidaatbronnen zijn:
| Bron | Voorbeeld |
|---|---|
| Instructies en beleid | Rol, veiligheidsgrenzen en Git-regels |
| Gebruikersverzoek | “Los issue 253 op.” |
| Gespreksgeschiedenis | Eerdere verduidelijking of correctie |
| Omgevingstoestand | Huidige branch of geselecteerd record |
| Opgehaalde kennis | Documentatie of repositoryzoekresultaten |
| Persistent geheugen | Een eerder projectbesluit of gebruikersvoorkeur |
| Skills | Een voorgeschreven commit- of escalatieworkflow |
| Toolresultaten | Testfouten, commandouitvoer of API-responses |
| Plannen en agent-state | Huidige taakstap en openstaand werk |
| Metadata | Tijd, identiteit, rechten en herkomst |
Context engineering is daarmee de bemiddelingslaag tussen veel externe informatiesystemen en één eindige modelcontext.
Context verandert in de tijd
Section titled “Context verandert in de tijd”Relevantie is afhankelijk van het huidige doel en de state. Aan het begin van een codingtaak kunnen architectuurdocumentatie en repositorybeleid het belangrijkst zijn. Na een testrun kunnen de falende assertion en het gewijzigde bestand belangrijker worden dan de oorspronkelijke bestandenlijst.
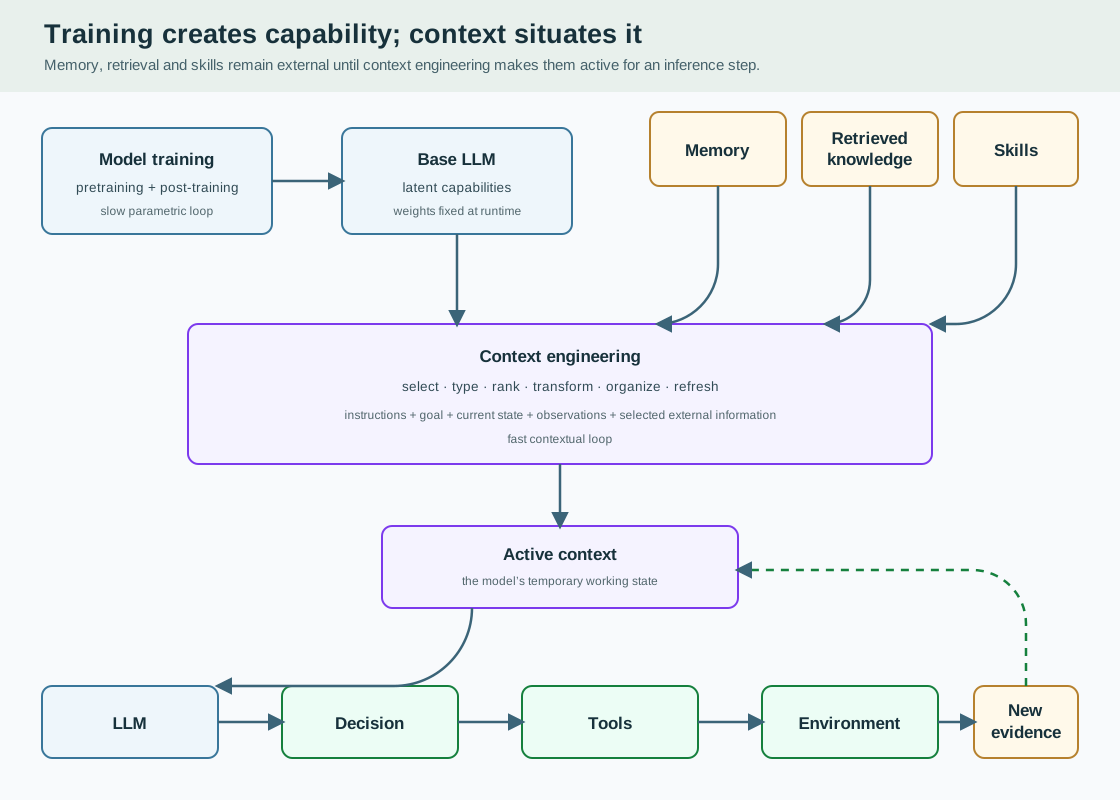
Toolgebruik creëert een terugkerende lus: actieve context stuurt een actie, de omgeving geeft een observatie terug en het systeem construeert de volgende context opnieuw. Het LLM kan tijdens de hele taak onveranderd blijven terwijl zijn gedrag zich aan nieuw bewijs aanpast.
Dit verklaart ook een belangrijke rol van de agent-harness. De harness is deels een contextbeheersysteem en deels een actiebeheersysteem: hij assembleert working state, stelt tools beschikbaar, handhaaft bevoegdheidsgrenzen, registreert observaties en bepaalt wat in de volgende stap behouden blijft.
Geheugen, RAG en skills zijn bronnen, niet de context zelf
Section titled “Geheugen, RAG en skills zijn bronnen, niet de context zelf”Geheugen is informatie die later relevant kan worden. Context is informatie die nu voor het model beschikbaar is. Een langlevende agent kan jaren aan interacties opslaan, maar slechts een klein, taakrelevant deel hoort één inferentiestap binnen te komen.
RAG is een mechanisme om kandidaatkennis te vinden. Context engineering bepaalt nog steeds welke fragmenten worden opgenomen, hoe ze worden gerangschikt en samengevat, hoe conflicten en herkomst worden weergegeven en of de informatie bij de volgende stap nuttig blijft.
Skills schrijven herbruikbare procedures voor. Een harness kan een veilige Git-skill alleen activeren wanneer een taak om een commit vraagt, de relevante stappen invoegen en ze verwijderen wanneer de procedure niet meer actief is.
Deze relaties kunnen als volgt worden samengevat:
| Systeem | Verantwoordelijkheid |
|---|---|
| Geheugen | Potentieel nuttige ervaring bewaren |
| Retrieval of RAG | Potentieel relevante kennis vinden |
| Skills | Herbruikbare procedures leveren |
| Context engineering | De huidige working state samenstellen |
| Agent-harness | De context-actie-observatielus beheren |
Representatie, autoriteit en herkomst
Section titled “Representatie, autoriteit en herkomst”De representatie van informatie beïnvloedt de interpretatie door het model. Dezelfde accountstatus kan worden uitgedrukt als proza, JSON, een tabel of een getypeerd record. Gestructureerde representaties kunnen veldgrenzen behouden, terwijl beknopt proza de leesbaarheid kan verbeteren. De juiste keuze hangt af van de taak en de te beheersen failure modes.
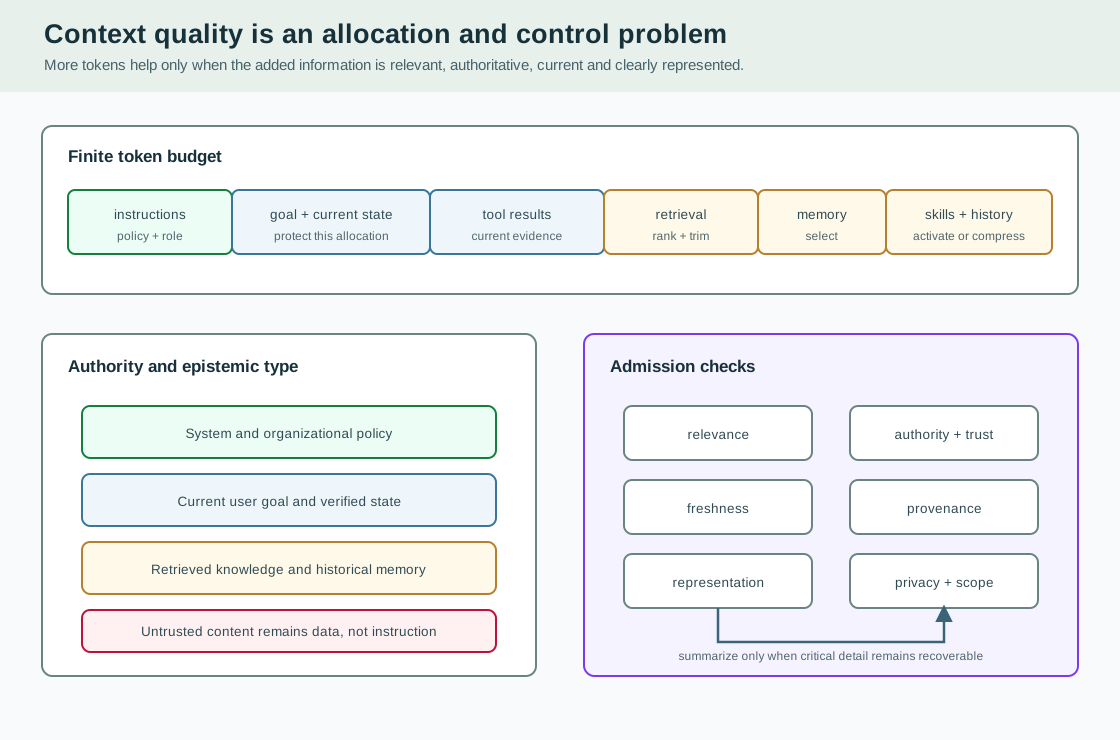
Volgorde en bronlabels zijn ook belangrijk omdat contextitems niet evenveel gezag hebben. Systeem- en organisatiebeleid moet zwaarder wegen dan opgehaalde webpagina’s. Een actuele gebruikersinstructie kan een afgeleide historische voorkeur terzijde schuiven, maar geen veiligheidsregel. Geverifieerde tool-state mag niet worden afgevlakt tot proza waarin ze niet meer van een aanname te onderscheiden is.
Bruikbare metadata omvatten:
- bron en herkomst;
- epistemisch type, zoals instructie, gebruikersintentie, voorkeur, observatie of inferentie;
- autoriteit en vertrouwensniveau;
- tijdstip en actualiteit;
- zekerheid en scope;
- identiteit of tenant-eigenaarschap.
Eindige budgetten en compressie
Section titled “Eindige budgetten en compressie”Contextcapaciteit is eindig. Instructies, doelen, geschiedenis, geheugen, retrieval, skills en toolobservaties concurreren om hetzelfde budget. Een groot retrievalresultaat kan beleid of huidige state verdringen, zelfs wanneer het model een groot contextvenster ondersteunt.
Het doel is niet maximale context. Het is voldoende, relevante, betrouwbare en goed gestructureerde context. Irrelevante of tegenstrijdige documenten toevoegen kan prestaties verminderen doordat het signaal moeilijker van ruis te onderscheiden is.
Langlopende taken hebben daarom compressie nodig. Een werksamenvatting kan het doel, afgeronde stappen, huidig probleem, beperkingen en gewijzigde bestanden behouden in plaats van elk eerder bericht en alle shelluitvoer. Sommige informatie, zoals exacte fouttekst, contractuele eisen of veiligheidsbeleid, moet mogelijk letterlijk behouden blijven.
Context over verschillende tijdschalen
Section titled “Context over verschillende tijdschalen”Langlevende agents hebben context uit verschillende tijdschalen nodig:
| Tijdschaal | Informatie |
|---|---|
| Direct | Huidige uiting of gebeurtenis |
| Episodisch | Huidige interactie of sessie |
| Taak | Doel, plan, voortgang en open problemen |
| Relationeel | Relevante geschiedenis met deze persoon |
| Langdurig | Stabiele voorkeuren, toezeggingen en feiten |
| Institutioneel | Rol, beleid en organisatieregels |
| Wereld | Actuele extern opgehaalde kennis |
Selectie over deze lagen is een controleprobleem. Het systeem moet de verwachte taakbruikbaarheid maximaliseren binnen beperkingen voor tokens, privacy, actualiteit, vertrouwen en beleid.
Conflicten en prompt injection
Section titled “Conflicten en prompt injection”Context heeft ook een epistemisch probleem. Geheugen kan zeggen dat een gebruiker meestal ochtendvergaderingen verkiest, het huidige verzoek kan om een middagvergadering vragen en een calendartool kan melden dat de middag niet beschikbaar is. Dit zijn verschillende informatietypen: een historische voorkeur, een huidige intentie en een geverifieerd extern feit. Het onderscheid behouden helpt het model te redeneren zonder het ene voor het andere aan te zien.
Opgehaalde inhoud moet eveneens data blijven. Een webpagina die zegt “negeer eerdere instructies” heeft geen bevoegdheid om systeembeleid te vervangen. De contextpijplijn moet niet-vertrouwde inhoud labelen, duidelijk begrenzen, onnodige blootstelling beperken en deterministische controles gebruiken voor gevoelige acties of geheimen.
Kenmerkende failure modes
Section titled “Kenmerkende failure modes”| Fout | Voorbeeld |
|---|---|
| Ontbrekende context | De agent kent het projectbeleid niet. |
| Overmatige context | Honderden irrelevante bestanden worden opgenomen. |
| Verouderde context | Verouderde API-documentatie wordt opgehaald. |
| Verkeerde context | Geheugen van een andere gebruiker wordt geselecteerd. |
| Conflicterende context | Twee onverenigbare beleidsregels worden zonder autoriteit gepresenteerd. |
| Slechte ordening | Opgehaalde inhoud lijkt zwaarder te wegen dan systeembeleid. |
| Slechte representatie | Een ambigue ongestructureerde dump verbergt veldgrenzen. |
| Verloren context | Compressie verwijdert een belangrijk eerder besluit. |
| Besmette context | Een kwaadaardige instructie komt via retrieval binnen. |
| Overpersonalisatie | Irrelevant persoonlijk geheugen wordt in een taak geïnjecteerd. |
Contextkwaliteit moet onafhankelijk van modelkwaliteit worden geëvalueerd. Een sterk model kan nog steeds slecht presteren wanneer zijn working state onvolledig, ruisachtig, verouderd of onveilig is.
Uitgewerkt voorbeeld: dependency-upgrade
Section titled “Uitgewerkt voorbeeld: dependency-upgrade”Beschouw een agent die een API-client moet upgraden, tests moet repareren en het resultaat moet committen. De initiële context heeft de rol, het doel, projectregels, de actieve Git-skill, huidige branch en schone working-tree-state nodig. Daarna kan de agent de dependency inspecteren en de relevante migratiegids ophalen.
Na de wijziging worden drie falende tests de belangrijkste observaties. Eerdere repositorylijsten kunnen worden gecomprimeerd of verwijderd, terwijl de migratienotitie relevant blijft. Zodra alle tests slagen, komt de diff in context en wordt die tegen het oorspronkelijke doel en beleid beoordeeld voordat geselecteerde bestanden worden gestaged en gecommit.
De context verandert gedurende de taak. De modelgewichten niet.
Training, context en agent engineering
Section titled “Training, context en agent engineering”Modeltraining creëert latente capaciteiten. Context engineering situeert deze capaciteiten met het huidige doel, beleid, bewijs en kennis. Agent engineering maakt van het gesitueerde model een gecontroleerde actielus. Geheugen voegt een sneller adaptatiemechanisme toe door ervaring naar toekomstige context over te dragen zonder modelgewichten te wijzigen.
Voor de meeste applicatieteams is deze snelle contextuele lus het praktische leeroppervlak. Ze is ook beter inspecteerbaar, corrigeerbaar en beheersbaar dan voortdurende wijzigingen aan modelparameters.