LLM-learning
Van data naar tokens
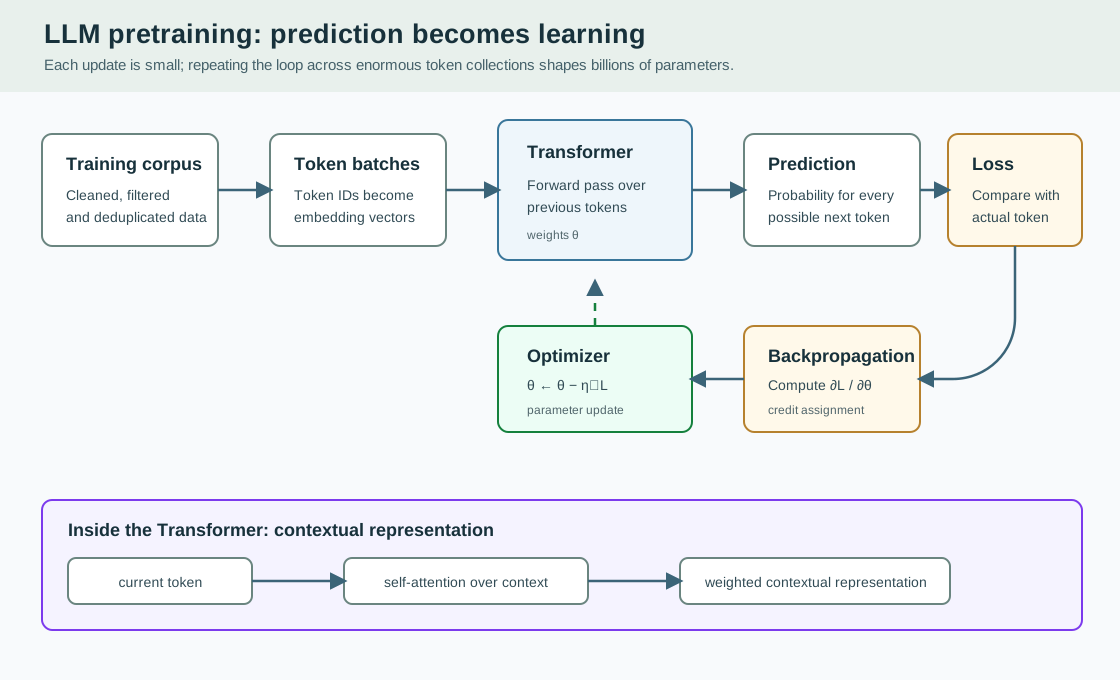
Section titled “Van data naar tokens”Training begint met een groot corpus dat boeken, websites, documentatie, wetenschappelijke artikelen, code, gesprekken en gestructureerde tekst kan bevatten. Multimodale modellen kunnen ook van afbeeldingen, audio of video leren. Voorafgaand aan training filtert data-engineering materiaal van lage kwaliteit of ongewenste inhoud, verwijdert duplicaten, herkent talen, balanceert bronnen en construeert geschikte voorbeelden.
Het corpus wordt niet simpelweg als doorzoekbare database in het model geïnstalleerd. Het levert voorbeelden waaruit het model statistische en structurele regelmatigheden leert.
Een LLM verwerkt tokens, niet rechtstreeks woorden. Een tokenizer kan een zin ongeveer zo opsplitsen:
["Artificial", " intelligence", " is", " useful", "."]Elk token krijgt een numerieke ID die naar een embedding wordt vertaald: een vector met veel aangeleerde getallen. Vroeg in de training bevatten deze vectoren weinig bruikbare structuur. Training organiseert ze geleidelijk tot representaties die relaties tussen tokens en contexten vastleggen.
Het volgende token voorspellen
Section titled “Het volgende token voorspellen”De centrale pretraining-taak voor de meeste generatieve LLMs is eenvoudig te formuleren: voorspel het volgende token op basis van alle voorgaande tokens. Voor de reeks The capital of France is produceert het model een kansverdeling over zijn vocabulaire in plaats van één antwoord.
| Kandidaat-token | Voorbeeldkans |
|---|---|
| Paris | 0,52 |
| Lyon | 0,08 |
| France | 0,05 |
| London | 0,03 |
Omdat het werkelijke volgende token tijdens training bekend is, kan een loss-functie de voorspelling beoordelen. De cross-entropy loss voor het juiste token y is:
L = -log P(y)Een kans van 0,52 voor Paris geeft een loss van ongeveer 0,65; een kans van 0,01 geeft ongeveer 4,61. Betere voorspellingen leveren dus een lagere loss op.
Backpropagation en parameterupdates
Section titled “Backpropagation en parameterupdates”Het model bevat parameters in embeddings, attention-lagen, feed-forward-netwerken en projectiematrices. Backpropagation berekent hoe de loss verandert ten opzichte van elke parameter:
partiële loss / partiële parameterEen optimizer voert vervolgens een kleine update uit, vaak samengevat als:
nieuwe parameters = oude parameters - learning rate * loss-gradiëntEén optimalisatiestap kan miljarden parameters met zeer kleine hoeveelheden veranderen. Training groepeert veel tokenreeksen in batches, combineert hun losses en herhaalt forward pass, lossberekening, backward pass en update voor enorme aantallen voorbeelden.
Attention en representation learning
Section titled “Attention en representation learning”Self-attention laat elke tokenrepresentatie relevante informatie uit eerdere tokens wegen. In vereenvoudigde vorm:
Attention(Q, K, V) = softmax(QK^T / sqrt(d_k)) VQueries, keys en values stellen attention heads in staat verschillende relaties vast te leggen, waaronder lokale syntaxis, verwijzingen over lange afstand, semantische gelijkenis en structurele patronen.
Het netwerk voert ook representation learning uit. Mensen hoeven kenmerken zoals “is een zelfstandig naamwoord”, “onderwerp” of “zinslengte” niet vooraf te definiëren. Door de lagen heen leert het model steeds contextuelere kenmerken die nuttig zijn voor voorspellingen. Dit is geen starre hiërarchie met één concept per laag: kennis is verdeeld over veel parameters en activaties.
Het voorspellen van uiteenlopende tekst beloont representaties van:
- taal, waaronder grammatica, syntaxis, spelling en discours;
- concepten en relaties, zoals Amsterdam als stad of Parijs als hoofdstad van Frankrijk;
- terugkerende redeneerpatronen, waaronder vergelijking, analogie, berekening en causaal argument;
- stijlen en genres, van broncode en wetenschappelijke artikelen tot gesprekken en juridische taal.
Eén individuele parameter staat normaal gesproken niet voor één feit zoals “Frankrijk”. De capaciteit ontstaat uit gedistribueerde berekeningen in het netwerk.
Pretraining en post-training
Section titled “Pretraining en post-training”Grootschalige next-token-training heet pretraining. Deze fase bouwt een base model of foundation model dat al tekst kan aanvullen, samenvatten, vertalen, sommige vragen kan beantwoorden en code kan schrijven.
Een ruwe next-token predictor is niet automatisch een bruikbare assistent. Post-training vormt hoe het model op gebruikers reageert. Supervised fine-tuning (SFT) verhoogt de waarschijnlijkheid van hoogwaardige voorbeeldantwoorden. Voorkeursmethoden vergelijken aannemelijke antwoorden en optimaliseren voor het gewenste gedrag. Deze familie omvat RLHF, RLAIF, reward modelling en Direct Preference Optimization (DPO).
| Pretraining | Post-training |
|---|---|
| Leert brede patronen en capaciteiten | Vormt gedrag en taakgebruik |
| Gebruikt enorme, brede datasets | Gebruikt kleinere, gecureerde datasets |
| Is grotendeels self-supervised | Gebruikt demonstraties, voorkeuren of beloningen |
| Is extreem rekenintensief | Is meestal kleiner van schaal |
Een bruikbare vuistregel is dat pretraining leert welke patronen bestaan, terwijl post-training leert hoe capaciteiten als assistent worden gebruikt. De grens is niet absoluut: post-training kan capaciteiten toevoegen en pretraining beïnvloedt ook gedrag.
Preference learning
Section titled “Preference learning”Voor één prompt kan een model meerdere aannemelijke antwoorden genereren. Menselijke of AI-beoordelaars kunnen die rangschikken. Training verhoogt vervolgens de kans op voorkeursgedrag, zoals instructies volgen, relevant blijven, helder communiceren en onveilig gedrag vermijden. Preference learning garandeert deze eigenschappen niet; het verschuift modelgedrag statistisch en vereist nog steeds evaluatie en controles op applicatieniveau.
Een gesprek is meestal geen weight learning
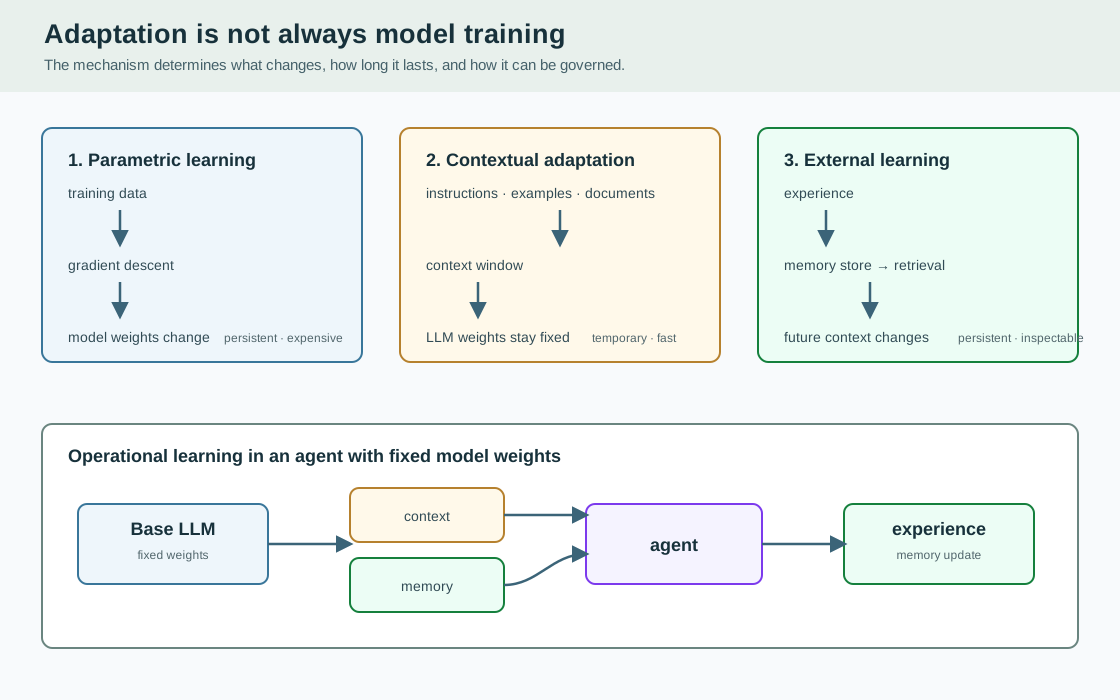
Section titled “Een gesprek is meestal geen weight learning”Tijdens normaal gebruik staan de modelgewichten vast. Als een gebruiker zegt: “Mijn project heet Apollo”, kan het model dit feit later in dezelfde context gebruiken, maar er heeft geen backpropagation plaatsgevonden. Dit is in-context learning: het model past een patroon, definitie of voorbeeld uit de huidige invoer toe.
Het verschil is belangrijk omdat meerdere mechanismen van buitenaf allemaal op “leren” kunnen lijken:
| Mechanisme | Verandert modelgewichten? | Persistentie |
|---|---|---|
| Prompt of context | Nee | Huidige context |
| Retrieval-augmented generation | Nee | Externe kennisopslag |
| Agentgeheugen | Nee | Extern persistent geheugen |
| Fine-tuning | Ja | Persistent |
| Verdere pretraining | Ja | Persistent |
| Volledige hertraining | Ja | Persistent |
Leren tegenover onthouden
Section titled “Leren tegenover onthouden”Leren verandert het vermogen van een systeem om een klasse taken uit te voeren. Onthouden maakt eerdere informatie opnieuw beschikbaar. Fine-tuning om medische codering te verbeteren is leren in modelparameters. De voorkeur van een gebruiker voor beknopte uitleg ophalen is onthouden via externe state.
Een agent kan dus operationeel leren terwijl het onderliggende LLM niet parametrisch leert. Een geheugensysteem kan ervaring vastleggen, retrieval kan relevante records in een toekomstige context plaatsen en het vaste model kan anders reageren. Extern geheugen is vaak gemakkelijker te inspecteren, corrigeren, verwijderen en beheersen dan informatie in modelgewichten.
Van model-learning naar systeemcapaciteit
Section titled “Van model-learning naar systeemcapaciteit”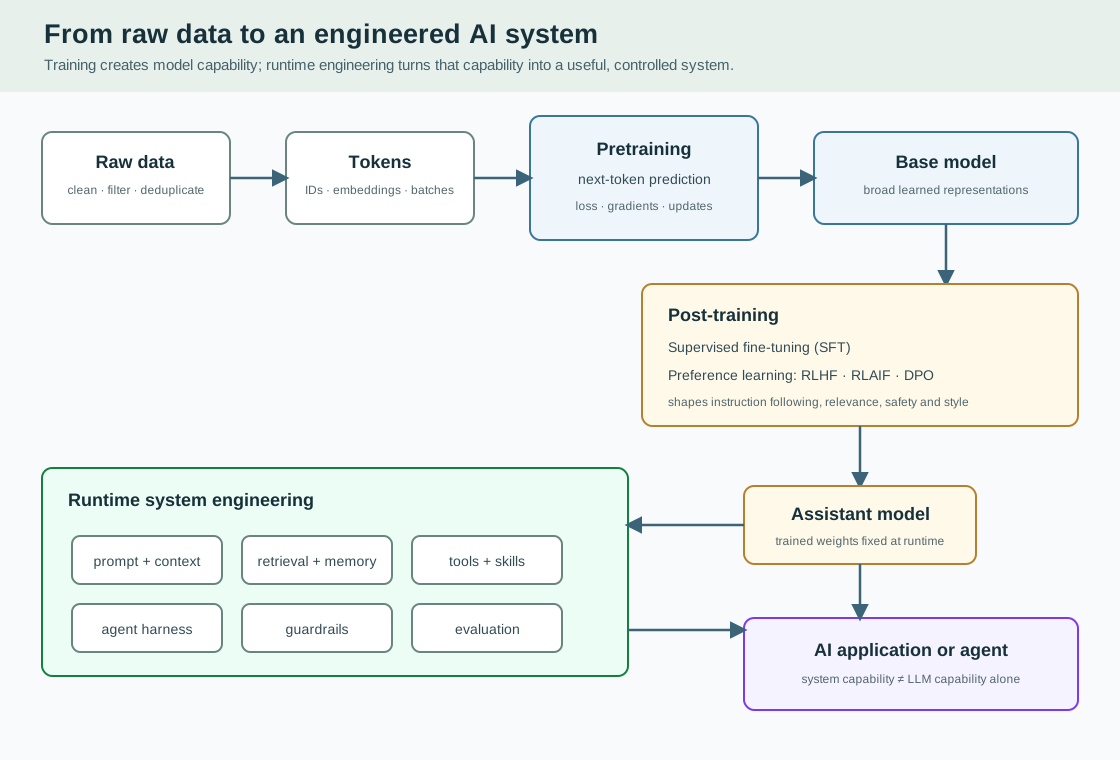
Next-token prediction kan geavanceerde capaciteiten opleveren omdat nauwkeurig voorspellen over diverse data het modelleren van latente structuren vereist. Het aanvullen van vergelijkingen beloont rekenkundige patronen; het aanvullen van code beloont kennis van syntaxis, APIs en algoritmen; het aanvullen van uitleg beloont het modelleren van premissen, conclusies en causale relaties.
Zodra het model is getraind, trainen de meeste applicatie-engineers het niet opnieuw. Zij bouwen er een runtimesysteem omheen. De uiteindelijke capaciteit komt voort uit het model plus context, retrieval, geheugen, tools, skills, de agent-harness, guardrails en evaluatie. Modelcapaciteit is dus een onderdeel van AI-systeemcapaciteit, niet de volledige definitie ervan.